Sobre hashtables
09 de Abril del 2022
Creo que la mayoría de los programadores saben qué son las hash tables (también conocidas como diccionarios o mapas). Normalmente, te suelen enseñar sólo una manera de implementarlas, pero hay muchas otras formas distintas. Durante el desarrollo de Quartz he tenido que implementar una hash table medianamente rápida y aquí quiero dejar todo lo que conozco sobre el tema, que no creo que sea mucho, pero quiero recopilarlo. La mayoría de esta información viene de distintas partes de internet, yo lo único que hago es unificarla aquí mismo.
¿Qué es una hash table?
Pues el concepto es muy sencillo: es una estructura de datos que permite relacionar una clave con un valor. Por ejemplo, digamos que quiero guardar la edad de la gente. En concreto, quiero recordar que Martín tiene 29 años y que Noelia tiene 32. Entonces la hash table guardaría:
| Clave | Valor |
|---|---|
| Martín | 29 |
| Noelia | 32 |
En una hash table debería poder hacerse estas dos operaciones esenciales:
- Inserción de una clave y un valor.
- Búsqueda por clave.
- Borrado por clave.
Pero nos queda aún lo más importante de las hash tables, la razón por la que es una estructura de datos ampliamente utilizada y, por lo tanto, muy importante: el rendimiento. Aquí dejo las complejidades de las operaciones principales (con respecto a la cantidad de elementos guardados), además del espacio en memoria utilizado:
| Caso peor | Caso medio | Caso Mejor | |
|---|---|---|---|
| Espacio | O(n) | Θ(n) | Ω(n) |
| Búsqueda | O(n) | Θ(1) | Ω(1) |
| Inserción | O(n) | Θ(1) | Ω(1) |
| Borrado | O(n) | Θ(1) | Ω(1) |
Lo interesante de esta estructura de datos es el caso normal para la búsqueda, inserción y borrado: su complejidad es constante. Eso significa que aunque tengas medio millón de datos guardados la complejidad será constante. Una aclaración importante es que normalmente no sólo basta con que la complejidad sea constante sino que también sea rápido. De nada vale que la complejidad sea constante si se tira un minuto buscando (tenga la cantidad de elementos que tenga).
El caso peor se refiere cuando la estructura de datos se ha degradado tanto que tiene que recorrerse todos los elementos del hash table para hacer cualquier operación (hay una manera para hacer que el caso peor también sea de O(1), pero requiere conocer las claves de antemano). En este caso no supone ninguna mejora sobre otras estructuras de datos como una lista enlazada.
Sabiendo qué es lo que hace vamos a ver cómo lo hace:
Toy Hash Table
Vamos a hacer una hash table de juguete para tener una idea de cómo funcionan. Por el momento vamos a obviar problemas que tienen las hash tables de verdad y vamos a quedarnos con la esencia. Lo que vamos a querer es asignar una letra del abecedario a un número.

De hecho, es tan sencillo que vamos a dar una implementación en C. Lo más fácil para hacerlo es declararnos un array con la cantidad de letras que tenemos (vamos a usar 27 porque no incluimos la ñ y todos son minúsculas):
char buckets[27];
Llamamos “buckets” a cada sitio donde una clave deja su valor (es el término que se suele utilizar). En este caso, imagina que cada cubo tiene una etiqueta con la letra que le corresponde y dentro del cubo tenemos el número.
Necesitaremos inicializar esa memoria a algo. La idea va a ser que si no has “insertado” la letra te devuelva -1:
void init_buckets() {
    memset(buckets, -1, sizeof(char) * 27);
}
Ahora necesitamos “mapear” una letra a su posición. Esto lo podemos hacer fácilmente conociendo sus posiciones en la tabla ASCII. Nosotros solo vamos a usar letras minúsculas, así que usamos la letra “a” (posición 97) para la posición 0 del array.
int map_key(char key) {
    return key - 97;
}
La inserción es muy fácil:
void insert(char key, int value) {
    int position = map_key(key);
    buckets[position] = value;
}
Y la búsqueda es muy similar a la inserción:
int find(char key) {
    int position = map_key(key);
    return buckets[position];
}
Con esto ya podemos jugar con nuestra hash table (de juguete)
int main() {
    init_buckets();
    insert('b', 12);
    insert('z', 23);
    insert('a', 2);
    printf("B: %d\n", find('b'));
    printf("Z: %d\n", find('z'));
    printf("A: %d\n", find('a'));
    printf("H: %d\n", find('h'));
}
Esto devuelve al ejecutarlo:
B: 12
Z: 23
A: 2
H: -1
La H no se insertó, por lo que no la encuentra y devuelve -1.
Strings y hashes
La verdad es que una hash table que solo permita caracteres como claves no nos vale de mucho. Vamos a intentar ahora usar cualquier string como clave. Para eso, tendremos que cambiar la función que mapea la clave con el bucket donde guarda su valor (lo que antes llamábamos como int map_key(char key)). Aquí entran las funciones hash. Una función hash lo que hace es devolvernos el “resumen” (un número entero) que identifica un cierto string. Mucha gente le ha dedicado mucho tiempo buscando los algoritmos más eficientes para implementar hashes, así que no tienes que preocuparte de implementar tú uno. Lo que sí deberías conocer es qué tipo de función hash deberías elegir para una hash table. Una hash table debería usar una función hash que:
- Sea rápida: Las claves se hashean todas al menos una vez, así que más nos vale que la función hash sea muy rápida. Esto deja fuera a todas las funciones hash criptográficas (md5, sha1, bcrypt y similares). Incluso la función hash criptográfica más rápida es demasiado lenta para una hash table.
- Minimice las colisiones.
El segundo requisito habla de algo que aún no he comentado. Las funciones hash tienen lo que se llaman “colisiones”. Se dice que se tiene una colisión cuando dos strings distintos dan el mismo resumen. Como podrás imaginar, es un problema para una hash table porque tenemos que manejar que dos elementos con distinta clave mapeen al mismo bucket. La mayor parte del trabajo y de la complejidad de la hash table se va a ir solucionando este problema. Que una función hash minimice las colisiones significa que debe hashear a cualquier bucket independientemente de dónde ha hasheado cualquier otro elemento. A esto se llama “simple uniform hashing”. Esto quiere decir que nos gustaría que nuestra hash table tenga una distribución uniforme de “sacar” cualquier número.
Solucionando colisiones: Open Addressing VS Separate Chaining
Como he dicho, las funciones hash pueden tener colisiones, por lo que nuestras tablas de hashes también. Toda la investigación sobre cómo mejorar las hash tables se centran en esto. Bien, pues hay tres estrategias principales:
Direct Addressing: Antes de presentar Open Addressing y Separate Chaining creo que está bien decir que lo que hemos hecho en nuestra “Toy Hash Table” se llama Driect Addressing. Realmente no es una manera para solucionar colisiones, pero he decidido ponerlo aquí porque realmente es una alternativa a las otras dos. La parte negativa ya la hemos comentado, necesitas tener una tabla del tamaño de la cantidad de claves que esperas guardar. En nuestro caso fue pequeña (sólo 27), pero en casos con muchas claves puede no ser práctico e incluso imposible (en caso de que requiriese más memoria de la que dispones).
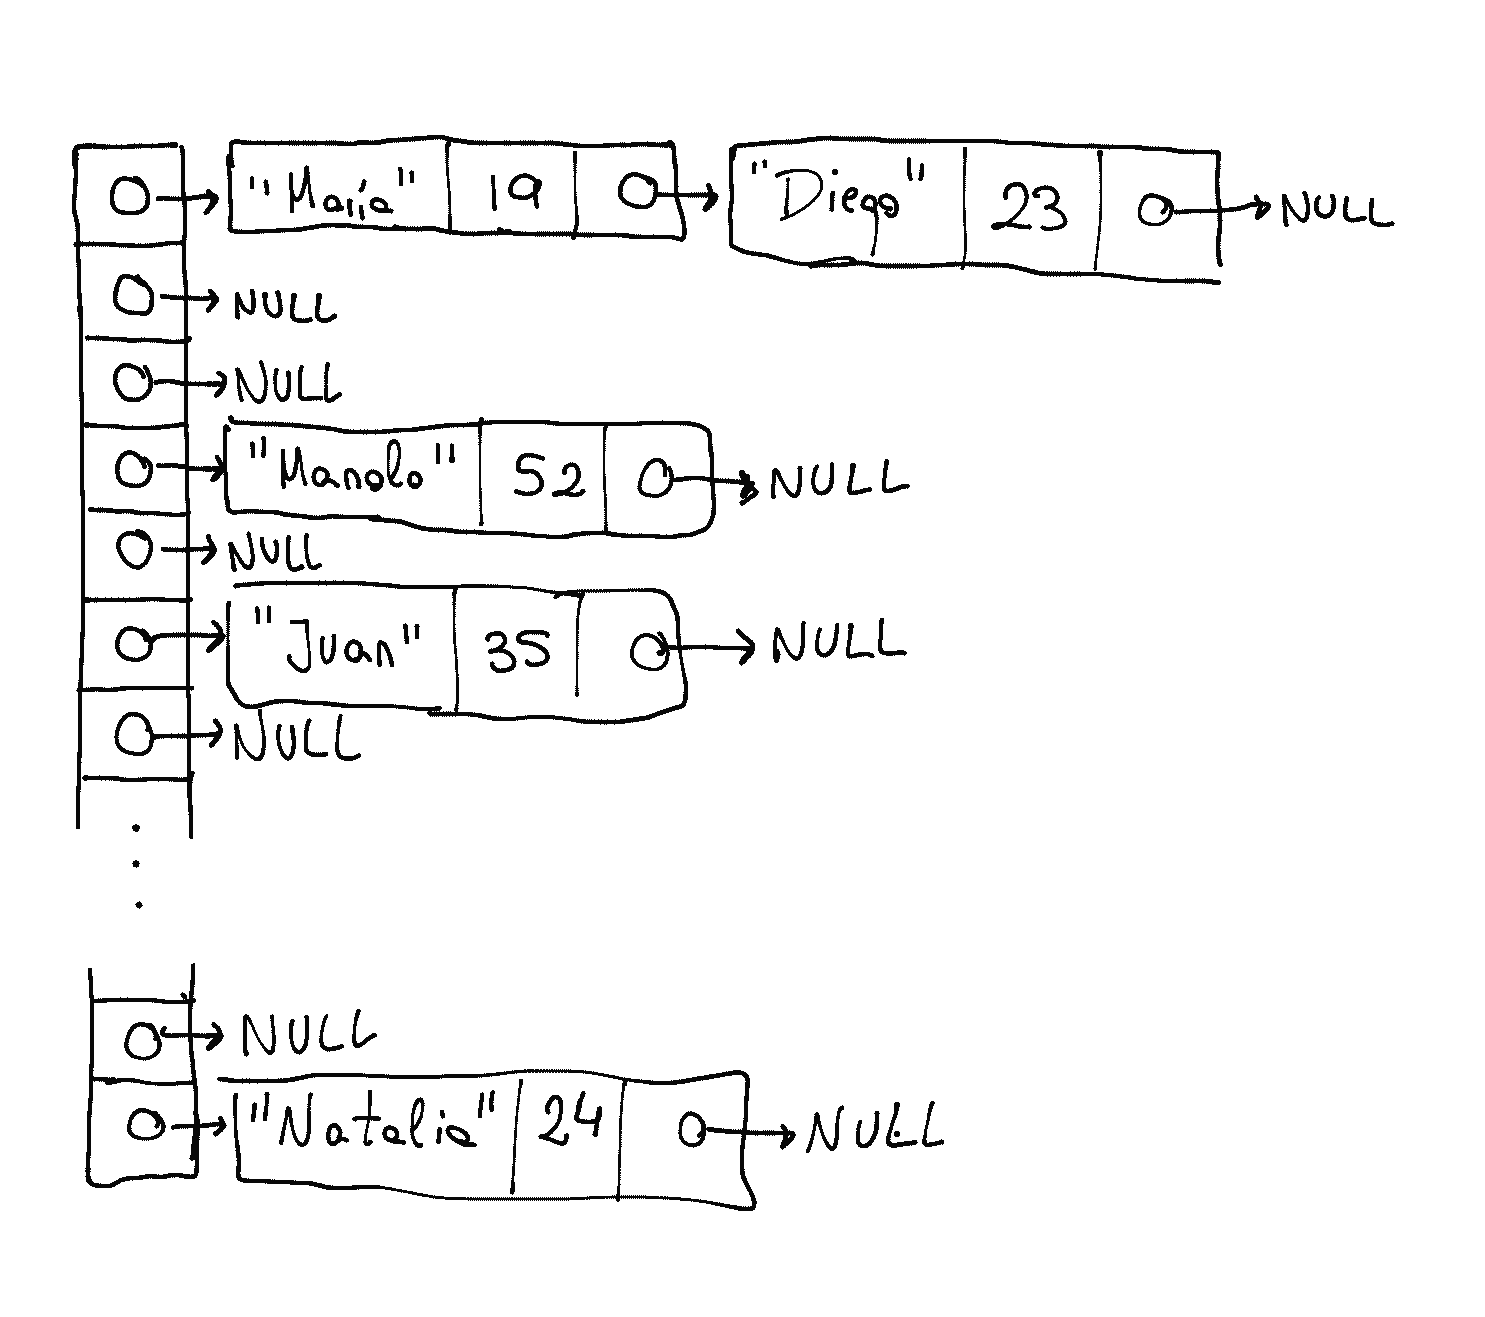
Separate Chaining: Es la forma más fácil, y por lo tanto, la que se suele usar para enseñar. Cada uno de los buckets de la hash table tiene una lista donde se guardan todos aquellos elementos que colisionen. Como los elementos guardan también su clave, lo que se hace para buscar es que se hashea la clave, se localiza la posición donde debería de estar el valor asociado y se recorre la lista comparando la clave de cada elemento con la clave del valor que queremos. La lista se puede implementar de muchas formas, algunas son estas:
- Listas enlazadas: Son la opción más simple, pero tiene algunas desventajas. Por ejemplo, no es una estructura de datos “cache friendly”, por lo que será más lenta que otras opciones que sí aprovechan la memoria cache. Para solucionar parcialmente este problema, puedes poner el primer elemento en el mismo array, de tal forma que no sea necesario seguir un puntero a otra posición de memoria que puede provocar un fallo de página.
Árbol binario de búsqueda autobalanceado: Puede mejorar mucho el caso peor de las operaciones de la hash table (de O(n) a O(log n)), pero es mucho más complejo que usar cualquiera de las otras dos opciones.
Vector (array dinámico): Es una alternativa también simple y mucho más “cache friendly” que las listas enlazadas.
Open Addressing: Es más compleja que la anterior. Todos los elementos de la hashtable se guardan en un único array, por lo que garantiza que se dispone contiguo en memoria. Cuando tenemos una colisión, guardamos el elemento en la primera posición del array que este libre siguiendo un patrón de búsqueda. Cuando se quiere buscar un elemento, se hashea su clave y nos dirigimos a la posición del array resultado de esta operación. Si el elemento que está en esa posición no es el que buscamos, continuamos buscando siguiendo el mismo patrón de búsqueda que usamos en la inserción hasta que:
- Encuentras una posición vacía. Si es así, es que el elemento no está en la tabla.
- Encontramos el elemento.
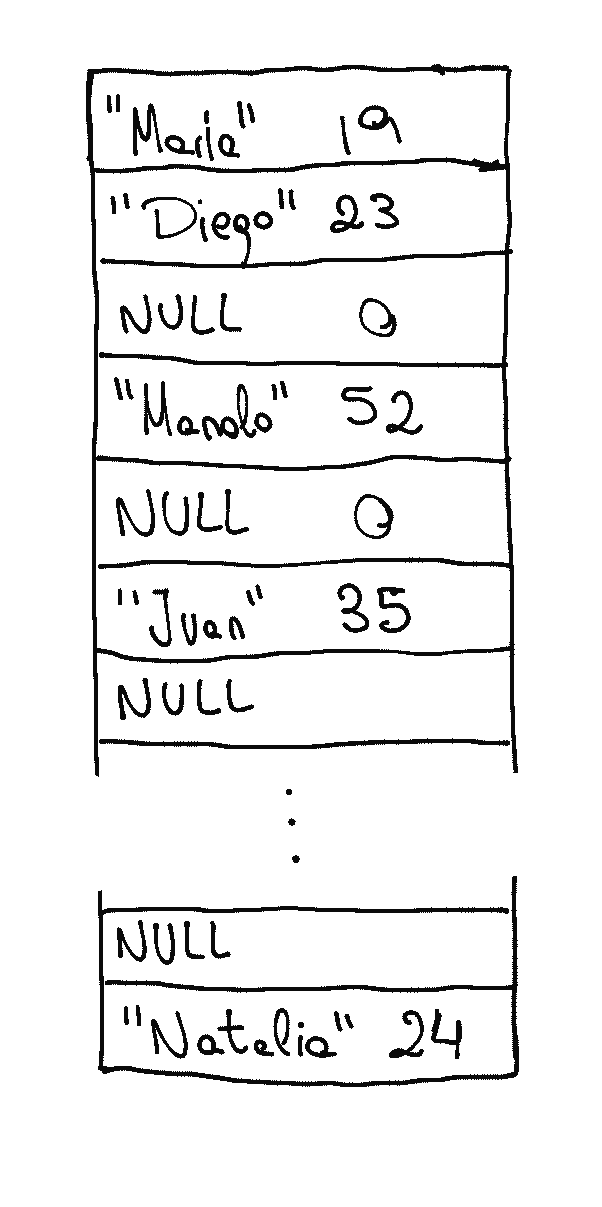
Ese proceso de buscar siguiendo el patrón de búsqueda que he comentado se suele llamar “probing”. Hay muchas formas para implementarlo (hay muchas más de las que pongo aquí, pero estas me parecen las más usadas):
Linear probing: Es la más simple y la más utilizada. El proceso de probing es lineal: al buscar, si el elemento actual no es el que busco, miro en el siguiente. Así hasta que o encuentras el elemento que quieres, o encuentras una posición vacía. Esta forma de hacer probing es cache friendly (aún más de lo que ya es open addressing). Esto es así porque si te traes una página de memoria a la caché, si vas leyendo uno a uno las posiciones del array (lo cual significa avanzar normalmente unos cuantos bytes cada vez) y si tu hash table no se ha degradado mucho, es muy probable que todo el proceso de búsqueda ocurra en esa misma página.
El problema principal de este proceso es lo que se llama clustering. Como hemos dicho, en open addressing con linear probing se inserta en el bucket donde “caes” y si no vas buscando en los siguientes hasta encontrar un sitio libre. Eso significa que vas a ocupar sitios donde deberían de “caer” otras claves. Esas otras claves tendrán que dejar su valor en otro sitio libre que encuentren más adelante. Eso formaría un grupo de elementos juntos, lo que llaman un “cluster”. Los clusters no son deseables porque, en caso de que el elemento no este en el hash table, tocará recorrer todo el cluster hasta encontrar el primer espacio libre, al final de éste. También en un cluster aumentan las distancias que tienes que recorrer para elementos que sí que están en la hash table, degradando su rendimiento.
Respecto a este último problema, hay una forma de mejorarlo: Robin Hood Hashing. Esto lo que trata es de reducir la media de las distancias (varianza) a la posición donde se espera encontrar a un elemento. Ahora todos los elementos guardan su distancia al punto donde se les espera encontrar (el sitio donde caen originalmente o, dicho de otra forma, donde hashea su clave). Al momento de insertar, se va comprobando la distancia que tiene el elemento a insertar con el elemento de la posición actual. Cuando el elemento a insertar tiene una distancia mayor (que se va incrementando a medida que se va buscando un sitio libre), se intercambia el elemento de la posición actual con el que se está insertando. De esta forma, todos los elementos van equiparando sus distancias.
Quadratic probing: El concepto es el mismo que linear probing, pero en vez de ir uno a uno, se suma un número al cuadrado al hash original de la clave. Ese número va aumentando cada vez. La sucesión es:
H + 1^2
H + 2^2
...
H + K^2
Siendo H el resultado de hashear la clave. También tiene problemas de clustering: Si dos elementos hashean al mismo número H, la secuencia será la misma.
- Double hashing: Cuando tienes una colisión la siguiente posición del array se determina volviendo a hashear con otra función hash la clave. Evita el clustering, a cambio de tener un peor aprovechamiento de la memoria caché. Una versión refinada es Cuckoo Hashing.
Tamaño
Hasta ahora no hemos hablado del tamaño de las hash tables. En nuestra toy hash table era fijo porque no tenía sentido que para 27 letras hiciésemos uno variable (y porque su cometido era introducirte a las hash tables). Puedes dar un tamaño fijo a las hash tables. Pero en ese caso te tienes que limitar a las del tipo Separate Chaining. Obviamente que puedas hacerlo no significa que debas hacerlo: fijar el tamaño hace que, si la cantidad de elementos que tiene que guardar la hash table es mayor que su tamaño, la hash table se degradará hasta tener una complejidad de búsqueda, inserción y borrado de O(n).
Así que lo ideal es que la hash table vaya cambiando de tamaño a medida que se vayan añadiendo elementos. Bien ahora nos encontramos con dos preguntas:
- ¿Cuándo deberías aumentar el tamaño?
- ¿Cuál es el tamaño que debería elegir?
Respecto a la primera pregunta lo que se hace es medir el factor de carga de la hash table y, cuando llegue a un límite, aumentar el tamaño. El factor de carga es un porcentaje que se calcula como:
factor de carga = cantidad de elementos / tamaño del hash table
El límite es muy importante. Dependiendo de qué método utilces para implementar tu hash table, no deberías dejar que pase de un cierto límite. En caso contrario tu hash table se va a degradar hasta el punto que sus operaciones tengan un coste lineal. Normalmente soluciones basadas en Separate chaining permiten un load factor del 100% sin sufrir una acusada degradación (de hecho, como en chaining guardamos los elementos que colisionan fuera del array de la hash table, el factor de carga máximo, que no recomendable, puede ser incluso mayor que un 100%). Por otro lado, las que se basen en Open Addressing es recomendable que no supere el 75%.
Ahora viene un problema derivado de la segunda pregunta (¿Cuál es el tamaño que debería elegir?). Resulta que cuando quieres buscar el bucket que le pertenece a una clave lo que haces es calcular el módulo del hash de la clave con el tamaño actual del hash table. Si el tamaño cambia, también lo hará el resultado de ese cálculo, por lo que debes volver a reubicar todos los elementos de la tabla. Esta operación tiene una complejidad O(n), por lo que no es deseable repetirla muchas veces. Aquí uno podría pensar que se puede obtener una respuesta a la segunda pregunta, y es un punto intermedio entre no provocar redimensionar muchas veces la tabla y no consumir mucha memoria.
Optimizaciones respecto al tamaño
Si intentas implementar una hash table tal como se ha dicho hasta ahora, será con toda seguridad lenta (o al menos no todo lo rápida que debería). Al ver que tiene problemas de rendimiento podrías coger un profiler y buscar el problema. Y verás que está probablemente en una línea: donde haces el módulo con el hash y el tamaño de la hash table. Resulta que la operación de módulo es muy ineficiente. Un procesador x86_64 de intel tarda entre 80 y 95 ciclos de cpu en ejecutar el módulo (Manual de intel).
Pero hay formas de remediarlo. Una de ellas supone usar potencias de dos como tamaño de la hash table. Gracias a esto podemos sustituir el módulo por un AND con una máscara. Simplemente calculamos la máscara como el tamaño del hash - 1. Luego, cada vez que quieras calcular el módulo, sólo tienes que hacer el AND entre la máscara y el hash. Acabamos de pasar de 80-95 ciclos para calcular el módulo a únicamente 1. Podemos ver un ejemplo para ver qué está ocurriendo:
Tenemos un tamaño de 8 cuya representación en binario es 1000. Su máscara será entonces 0111. Tenemos por ejemplo que el hash es 53 (110101). Calculamos el AND entre 8 y 53 (110101 & 000111) lo cual da 5 (0101).
Con esto ya puedes tener una hash table razonablemente rápida. Aún quedan cosas por contar, como por ejemplo los hash attacks, pero este post es ya muy largo como para continuar.
Bibliografía
- Crafting Interpreters La introducción esta basada en la que hace Robert Nystrom en este libro, además que implementa una hash table para su intérprete. Sin embargo, aquí va directo al grano, por lo que sólo explica lo esencial para implementar la hash table de Lox.
- Introduction to algorithms (Third edition, pag 253) He simplificado muchas cosas (no incluyo, por ejemplo, las complejidades de cada uno de los métodos para lidiar con colisiones, ni tampoco explicaciones sobre por qué es así). Realmente el grueso del artículo es un resumen del capítulo 11 de este libro.